

今天遇到一个很典型的坑:Memos 里带图片的笔记怎么都存不上,右上角弹出一句英文——
Failed to save memo: unsupported content type text/html;charset=utf-8
很多人第一反应是 Memos 版本问题、数据库问题,或者你配的 S3/COS 存储出问题了。这次都不是。真正拦你的是服务器前面的宝塔 WAF。
这篇按实际操作顺序,把定位、原理、修复、验证、回滚完整写下来;关键概念都用白话解释,命令逐行加了中文注释。
一、先说结论
Memos 上传附件时,请求体(笔记正文 + 图片一起打包)超过了 nginx 的 client_body_buffer_size 512k,宝塔 WAF 判定为「缓冲区溢出」,直接返回它自己的 HTML 拦截页。Memos 前端期待 JSON,收到 HTML 就报了那句看不懂的「unsupported content type」。
修复方法:给 Memos 的附件上传接口加一条 WAF URL 白名单,让这个接口不再走那条大小检查。
二、先看现象,别急着改代码
三个特征值得先记下来:
- 纯文字笔记能保存,一带附件就失败;
- 66KB 的小图、8.7MB 的 PDF 报同一个错;
- 提示语是「content type text/html」,不是「文件太大」。
这三条放在一起,基本可以判断:请求根本没到 Memos,是前面的某一层挡了,并且回了一个 HTML 页面。
三、先搞懂:User-Agent 是什么?
你在浏览器里访问一个网址,浏览器除了发「我要这个页面」,还会附上一张名片,这张名片就是 User-Agent(简称 UA)。
它长这样:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36
(KHTML, like Gecko) Chrome/157.0.0.0 Safari/537.36翻译成人话:「我是 Windows 10 上的 Chrome 157 浏览器」。用手机访问,它会写自己是 iPhone / Android;用爬虫或命令行工具,它会写 curl/8.14.1、Go-http-client/2.0 这类。
服务器拿它干什么?三件事:
- 适配页面:识别手机还是电脑,决定给哪种排版;
- 统计:区分真人访问和搜索引擎爬虫;
- 风控:WAF 看到 UA 是
curl、python-requests、空的,或者明显是扫描器的特征,就会提高警惕,甚至直接拦截。
但要注意:UA 是可以随便伪造的。任何程序都能把自己写成 Chrome。所以它只能当「参考信息」,不能当身份证用。我们在日志里看到 UA,主要是为了判断「这个请求是真人浏览器发的,还是自动化工具发的」。
前面 WAF 日志里那一列 Chrome/157,就是访客的 UA。
四、第二步:看 WAF 日志(关键证据)
宝塔 WAF 的日志按站点存放,路径规律是:
# 查看指定站点当天的 WAF 日志(实时跟踪)
tail -f /www/wwwlogs/btwaf/csj.help0564.com_2026-11-13.log
马上能看到这样的记录:
["2026-11-13 19:39:22","114.104.22.75","POST",
 "/memos.api.v1.AttachmentService/UploadAttachment",
 "Chrome/157", "upload",
"传递的参数超过接受参数的大小...", "Nginx缓冲区溢出"]字段依次是:时间、来源 IP、请求方法、请求路径、User-Agent、命中的规则名、说明、拦截原因。这里规则名是 upload,原因是 Nginx缓冲区溢出——原因锁定。
当天这类拦截一共 11 次,全部打在 Memos 的附件接口上。
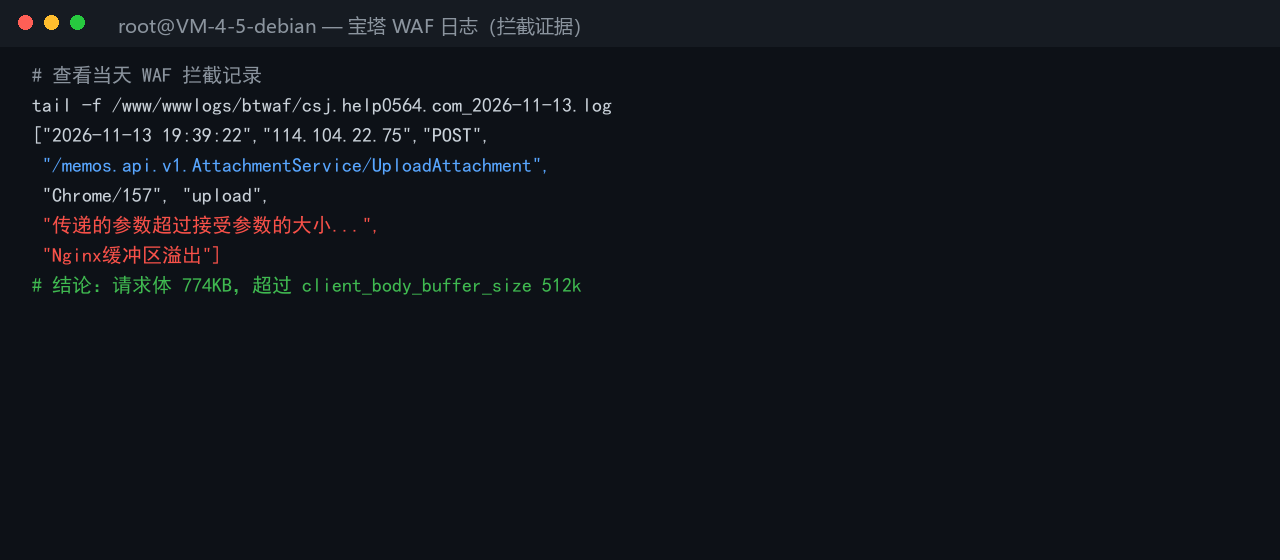
图 1:WAF 日志明确写着规则 upload、原因「Nginx缓冲区溢出」
五、原理:为什么 66KB 的图片也会被拦
关键在 nginx 的一个参数:
# 查 nginx 的请求体缓冲区设置
grep -rn client_body_buffer_size /www/server/nginx/conf/
# 输出:/www/server/nginx/conf/proxy.conf:3:client_body_buffer_size 512k;
512k 的意思是:请求体超过 512KB 就会触发这条检查。注意——它算的是整个请求体,不是单个文件。
Memos 上传附件时,是把「笔记正文 + 附件」打包成一个 application/proto 请求发出去的。你那条笔记正文本身就很长(含 HTML、代码片段),再加两张图,很快就超过 512KB。日志里 content-length: 774139(约 756KB)就是证据。
然后 WAF 做的事是:不转发给 Memos,直接返回自己的拦截页。这个页面是 HTML。Memos 前端拿到的不是 JSON,于是抛出那句看起来毫不相干的错误。
六、动手前先搞懂:WAF 是怎么工作的?
宝塔 WAF 不是独立软件,它是跑在 nginx 里面的脚本。请求进 nginx 后,先经过 WAF 的脚本判断,再决定「放行给网站」还是「直接返回拦截页」。
这里面有两个词,用白话解释:
1)Lua 是什么?
Lua 是一种轻量级脚本语言。宝塔 WAF 就是用 Lua 写的,通过 nginx 的 ngx_lua 模块加载,所以它能在 nginx 处理请求的瞬间插进去做判断。
它的工作方式是:nginx 启动时,把规则文件读进内存(由 init.lua 完成)。之后每个请求进来,Lua 拿内存里的规则去比对。正因为是「启动时读进内存」,所以你改完规则文件,必须 reload nginx 才会重新加载,否则改了也不生效。
2)per-site 数组是什么?
site.json 是一个大 JSON 文件,里面每个域名一段配置,就像通讯录里每个人一条记录。这种「按站点分别配置」的结构,就叫 per-site(逐站点)。
其中有一段叫 url_white,看起来正是「URL 白名单」。但这是旧版遗留字段——当前 WAF 的 Lua 代码并不读它。面板上那个「URL 加白」按钮,写的正是这里,所以点了没效果。
真正生效的,是另一个文件:/www/server/btwaf/rule/url_white.json(全局规则文件)。对应代码在 init.lua 第 96 行:
-- init.lua 第 96 行:把 rule/url_white.json 读进内存
BTWAF_RULES.url_white_rules = Public.read_file('url_white')
然后在 modules/white_balck.lua 第 165 行,拿这份规则去匹配请求路径:
-- 拿白名单去匹配当前请求的路径(request_uri)
if BTWAF_OBJS.request_check.is_ngx_match(BTWAF_RULES.url_white_rules, ngx.ctx.request_uri, false) then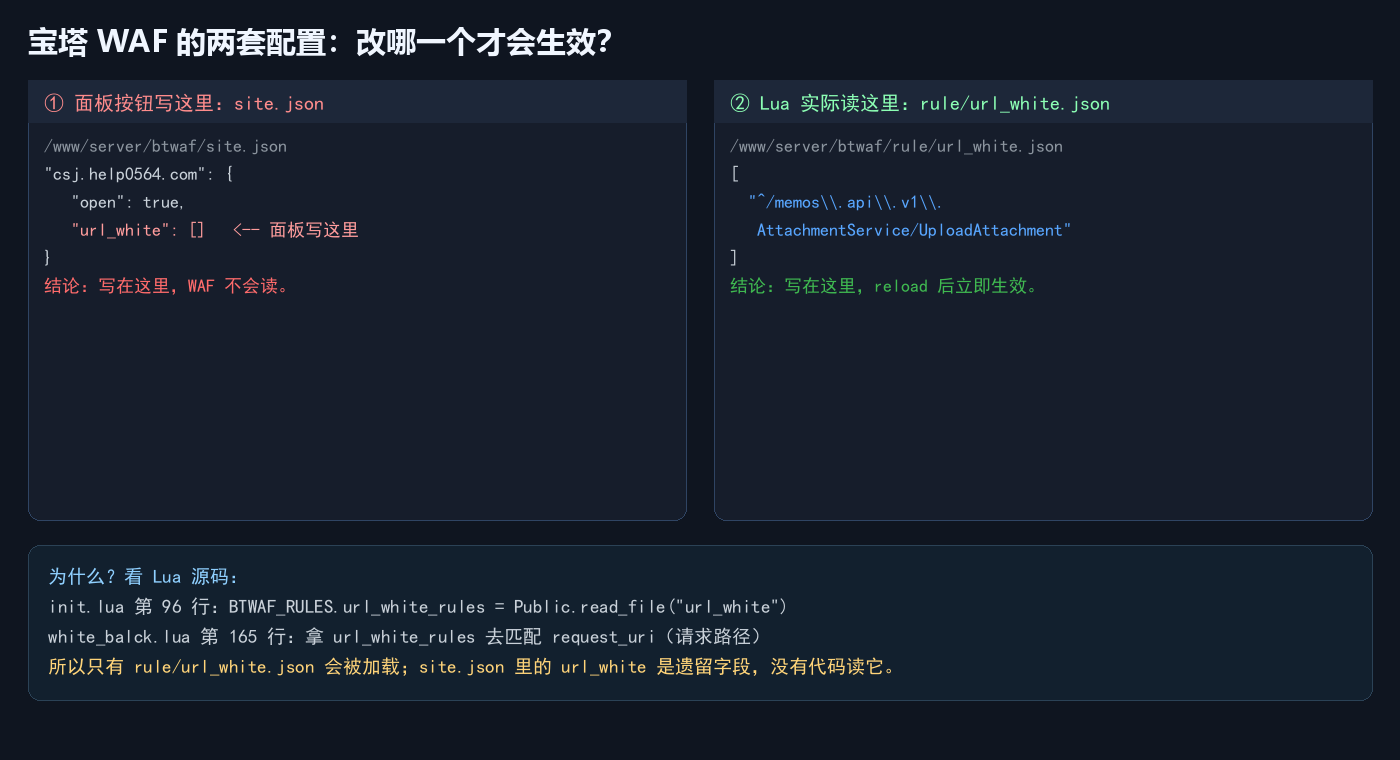
图 2:左边是面板按钮写入的位置(不生效),右边是 Lua 实际读取的位置(生效)
七、修复步骤(含完整路径)
步骤 0:登录服务器,先备份
# 登录(用你的方式,比如 FinalShell / ssh)
ssh root@你的服务器IP

# 备份原规则文件,文件名带时间戳,方便回滚
cp -a /www/server/btwaf/rule/url_white.json \
      /root/url_white.json.bak-$(date +%F-%H%M)

# 看一眼备份是否生成
ls -l /root/url_white.json.bak-*
步骤 1:用 python 追加规则(逐行解释)
为什么要用 python,不直接用记事本改?
因为这个文件是 JSON 格式,JSON 里的反斜杠是「转义符」:想表示一个真正的反斜杠,必须写成两个。而我们的正则里需要 \.(表示「一个字面意义的点」)。手写时很容易多写一层或少写一层:
- 写成
.→ 变成「任意字符」,规则过宽; - 写成
\\.→ 匹配不到,规则失效。
用 Python 的 json.dump 会自动处理这层转义,避免人为出错。
# 用宝塔自带的 python 执行(不要用系统 python,环境/权限更一致)
/www/server/panel/pyenv/bin/python3 - <<'EOF'
import json

path = '/www/server/btwaf/rule/url_white.json'
rules = json.load(open(path))          # 读出已有规则(当前是空数组 [])

pattern = r'^/memos\.api\.v1\.AttachmentService/UploadAttachment'
# r'...' 是「原始字符串」:反斜杠按字面保留,不会被 Python 再转义一层

if pattern not in rules:               # 先判断,避免重复添加
    rules.append(pattern)

json.dump(rules, open(path, 'w'), ensure_ascii=False, indent=1)
# 写回文件:ensure_ascii=False 让中文不变成 \uXXXX,indent=1 让格式好读

print(rules)                           # 打印出来,方便核对
EOF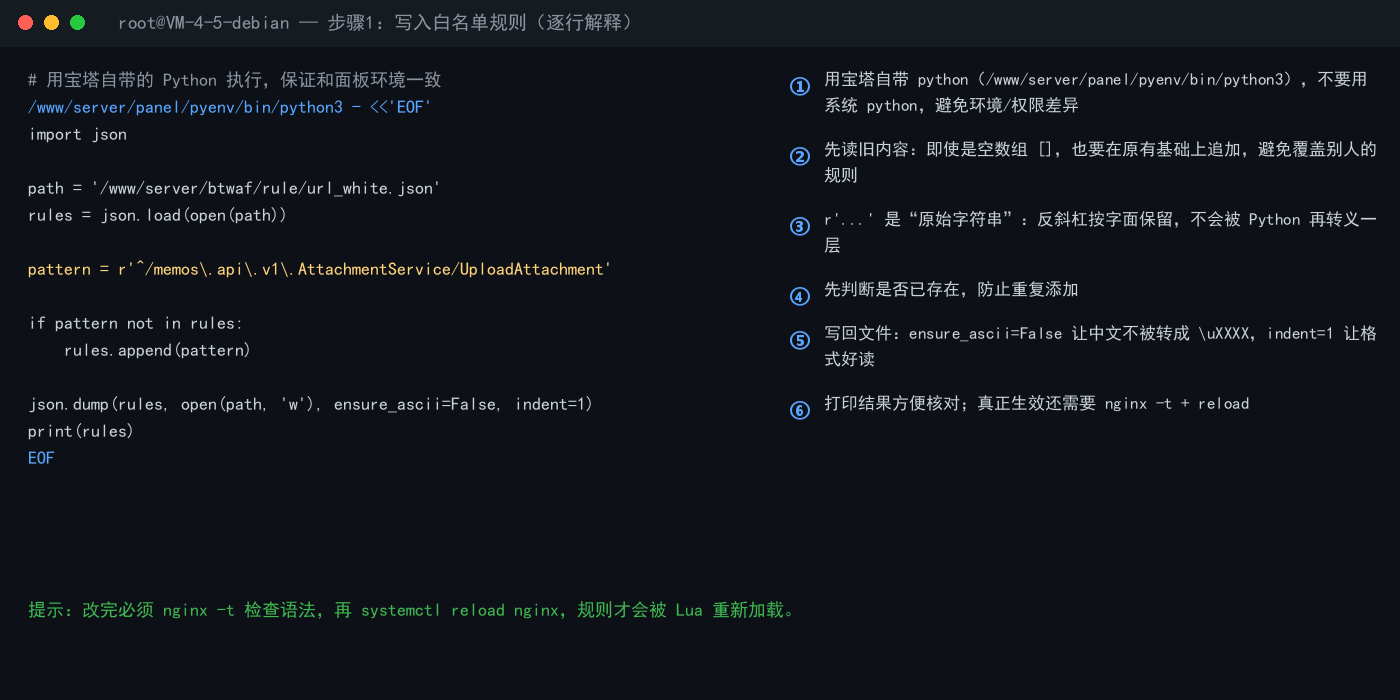
图 3:每一行代码在做什么(右侧编号对应左侧行)
步骤 2:核对写进去的内容
# 直接看文件内容:应该看到双反斜杠(JSON 的转义写法)
cat /www/server/btwaf/rule/url_white.json

# 更可靠的方式:让 python 读出来,确认长度和真实字符
/www/server/panel/pyenv/bin/python3 -c "import json;print([repr(x) for x in json.load(open('/www/server/btwaf/rule/url_white.json'))])"
期望结果(长度 52,说明正则里是单反斜杠的 \.):
parsed: '^/memos\\.api\\.v1\\.AttachmentService/UploadAttachment' len 52附:这条规则逐字符拆开看
完整的一行是:
^/memos\\.api\\.v1\\.AttachmentService/UploadAttachment| 片段 | 白话含义 |
|---|---|
^ |
「锚点」,表示必须从路径开头匹配。少了它,/xxx/memos... 这种也会被放行。 |
/ |
URL 的路径分隔符。WAF 比对的是 request_uri(路径+参数),不含域名,所以以 / 开头。 |
memos |
普通文本,Memos 的 API 前缀。 |
\. |
转义的点。正则里 . 默认表示「任意一个字符」;前面加反斜杠 \. 才表示「一个真正的点」。这里对应 memos.api 中间那个点。 |
api、v1 |
普通文本:接口名与版本号。 |
AttachmentService |
普通文本:Memos 的「附件服务」。 |
UploadAttachment |
普通文本:具体方法「上传附件」。这就是被 WAF 拦的那个接口。 |
文件里的 \\ |
JSON 转义:JSON 里想存一个反斜杠,必须写两个。所以文件里看到的是 \\.,读进程序后变成 \.。 |
结尾没有 $ |
表示只要求「以这段开头」。后面带 ?foo=1 之类的参数也能匹配;如果加了 $(必须完全一致),反而会漏掉带参数的请求。 |
整条规则翻译成一句话:凡是以 /memos.api.v1.AttachmentService/UploadAttachment 开头的请求,都跳过 WAF 的 upload(大小)检查。
补充两点:WAF 匹配是不区分大小写的;而且只按路径匹配、不区分域名,所以同机所有站点都会放行这个路径。
步骤 3:校验并重载 nginx
# 先检查配置语法,避免把网站搞挂
nginx -t

# WAF 规则是 nginx 启动时读进内存的,必须 reload 才会重新加载
systemctl reload nginx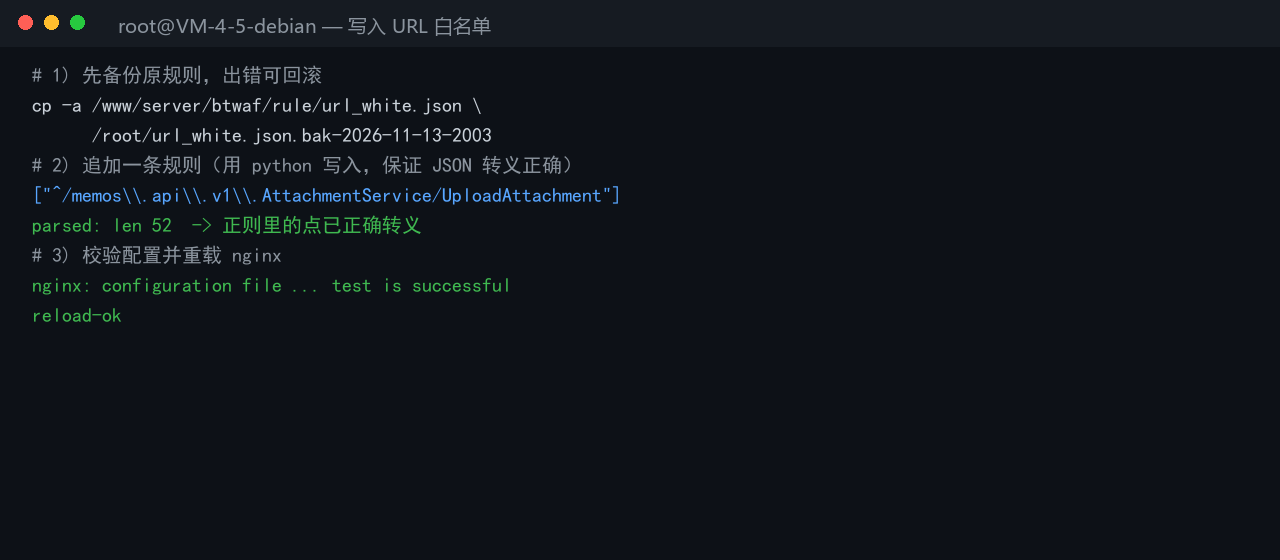
图 4:备份 → 追加规则 → nginx -t 通过 → reload 生效
八、验证:既要证明修好了,也要证明防护没被削弱
只测「能上传」不够,必须同时测「别的路径还拦不拦」,这叫双向验证。
A. 白名单路径 + 1MB 请求体
# 造一个 1MB 的测试文件
head -c 1048576 /dev/zero > /tmp/big.bin

# 打到白名单路径,看 WAF 是否放行
curl -sk -o /tmp/ok.out -w 'http=%{http_code} type=%{content_type}\n' \
  -H 'Content-Type: application/proto' --data-binary @/tmp/big.bin \
  https://csj.help0564.com/memos.api.v1.AttachmentService/UploadAttachment
期望结果:
http=400  type=application/json
{"code":"invalid_argument","message":"unmarshal message: ..."}
这里的 400 是 Memos 自己在说「内容格式不对」——说明请求已经到达 Memos,WAF 没再拦。
B. 非白名单路径 + 同样的 1MB
# 换一个普通路径,验证 WAF 仍然有效
curl -sk -o /tmp/blocked.out -w 'http=%{http_code} type=%{content_type}\n' \
  -H 'Content-Type: application/octet-stream' --data-binary @/tmp/big.bin \
  https://csj.help0564.com/index.php

# 统计是否出现 WAF 拦截页的特征
grep -c '缓冲区溢出' /tmp/blocked.out
期望结果:
http=200 type=text/html 缓冲区溢出 x1返回 200 + HTML、能搜到「缓冲区溢出」,说明其他路径照样被拦,防护没有削弱。
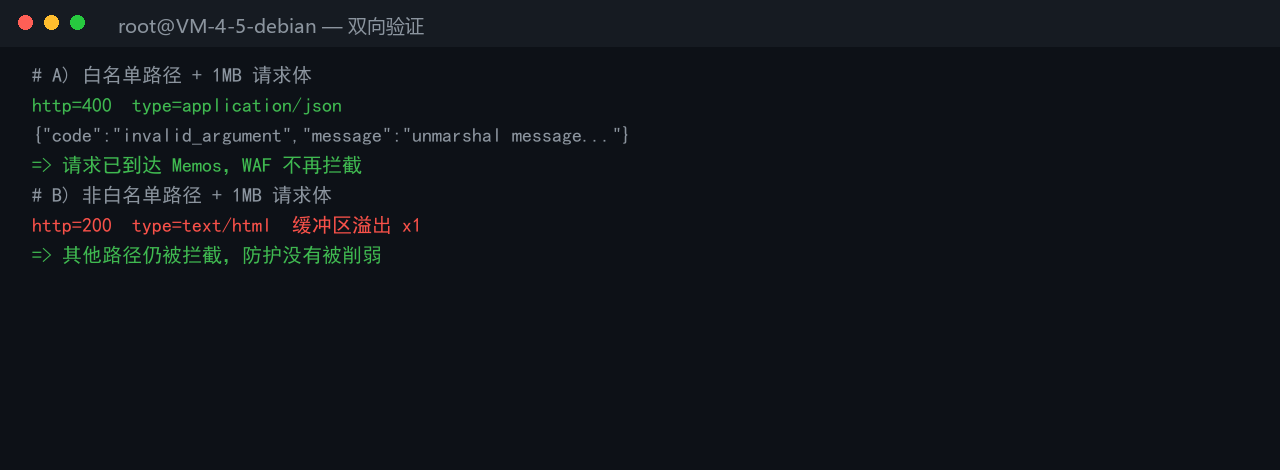
图 5:A 路径放行(Memos 返回 JSON)、B 路径仍被 WAF 拦截
九、出问题怎么回滚
# 把备份的规则文件覆盖回去
cp -a /root/url_white.json.bak-* /www/server/btwaf/rule/url_white.json

# 重新加载,立刻恢复原状
nginx -t && systemctl reload nginx
十、三个必须知道的坑
- 面板「URL 加白」按钮不生效:它改的是
site.json的 per-site 字段,WAF 的 Lua 读的是rule/url_white.json。手动改全局文件才有效。 - 这条规则是全局的:URL 白名单只按路径匹配、不区分域名,本机所有站点都会放行该路径。好在
/memos.api.v1.AttachmentService/UploadAttachment是 Memos 专属接口。 - 上传成功只是第一关:Memos 若配了 S3 兼容存储(如腾讯云 COS),放行后还要确认存储能写入——密钥、bucket、endpoint、路径样式任何一项不对都会报错,但那时错误会来自 Memos 本身,而不是 HTML 拦截页。
十一、小结
看到「unsupported content type text/html」,先别怀疑应用。问自己一句:这个 HTML 是谁返回的? 顺着 WAF 日志查下去,十分钟能定位。修复只需要一条白名单规则,但验证一定要双向——只证明「能上传」而没证明「其他路径仍被拦」,等于没验证。
最后:改配置前先备份,改完先 nginx -t 再 reload,这两步能省掉 90% 的深夜事故。
相关阅读
如果你还没部署 Memos,或想从头搭一套,可以先看这篇:
Docker 部署碎片化知识卡片管理系统 Memos