

这是一次真实的生产服务器维护记录。机器是腾讯云上一台 Debian 12,跑着 RustDesk 服务端、Syncthing 同步、memos 笔记、wiz 知识库和一套宝塔面板。维护从一次只读体检开始,最后完成了补丁升级、容器换代、磁盘回收和三项故障修复。
环境与起点
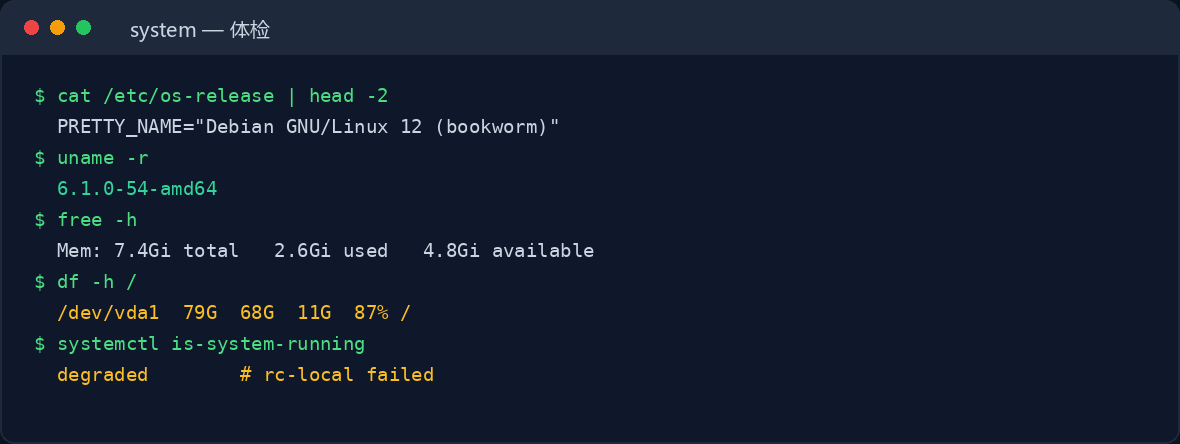
2 核 7.4G,79G 系统盘,维护前已用 87%;SSH 只开密钥登录;Docker 29.6.1;宿主机还跑着 nginx、frps、MySQL、Redis 和三个 COS 挂载。
一、安全补丁:13 个包,含内核
apt list --upgradable 列出 13 个来自 bookworm-security 的更新,包括内核 6.1.187 → 6.1.190、mariadb 客户端、ca-certificates。直接 dist-upgrade,然后重启加载新内核。
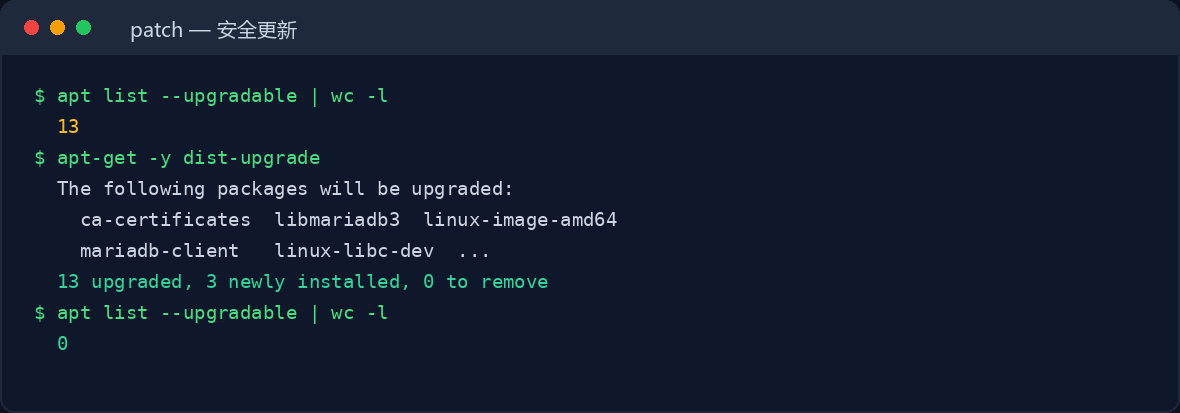
顺带安装了 unattended-upgrades,并把更新范围收窄为只装 Debian-Security:Debian 默认配置会把整个 main 仓库算进自动更新,对生产机来说太激进,需要注释掉 label=Debian 那一行。同时设置 Automatic-Reboot false,内核更新只装不重启。
二、容器:先看清版本,再决定动谁
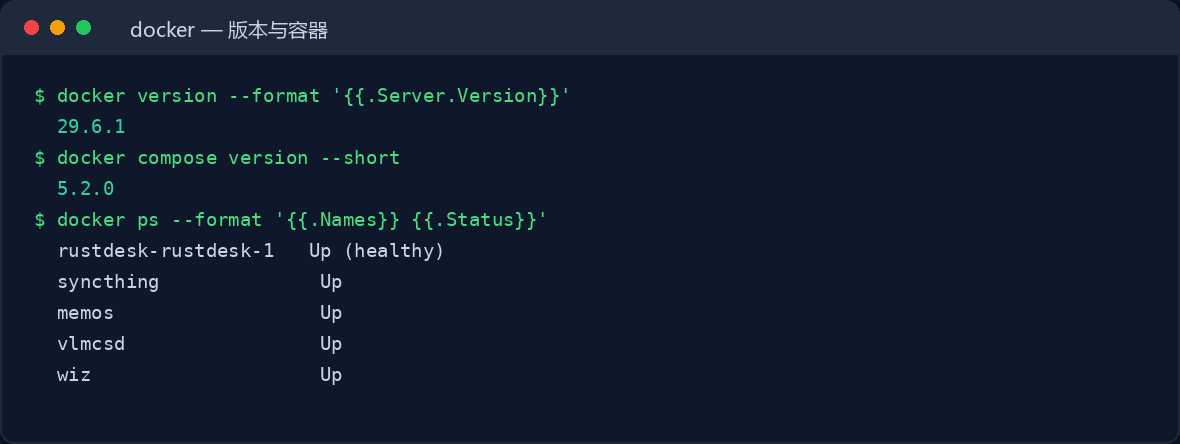
docker version 显示 29.6.1,compose v5.2.0,buildx 0.35.0,containerd 2.2.5,全部是仓库最新。真正需要处理的是镜像:
RustDesk:换二进制而不是换镜像
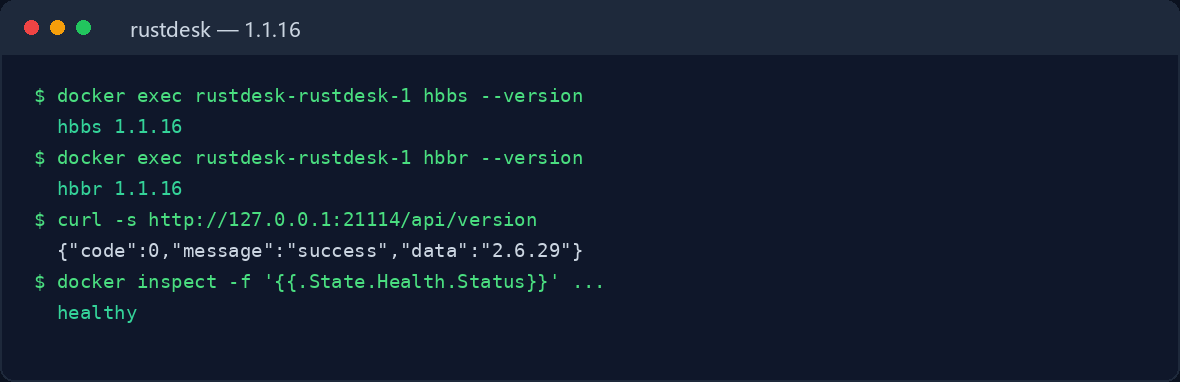
用的镜像是 lejianwen/rustdesk-server-s6:latest,镜像标签写着 v0.1.2,但容器里 hbbs --version 才是真相:1.1.14。上游已经到 1.1.16,而 fork 还没跟进打包。
为了保留 Web 控制台和 API,我没有换镜像,而是从官方 1.1.16 deb 里取出 hbbs/hbbr,基于原镜像构建了一个薄镜像:
FROM lejianwen/rustdesk-server-s6:latest
COPY hbbs hbbr /usr/bin/
RUN chmod 755 /usr/bin/hbbs /usr/bin/hbbr关键是不动数据卷:/data/id_ed25519 私钥、db_v2.sqlite3 和端口都不变,客户端不需要改任何配置。升级后核对公钥与升级前逐字节一致,这是判断“客户端还能不能连”的唯一标准。
Syncthing 与 memos
Syncthing 用 compose 原地重建,从 v2.0.16 升到 v2.1.7,网络别名 syncthing 保留,四个同步文件夹全部恢复 idle。
memos 从 0.30.0 升到 0.31.0,数据目录是宿主机 bind mount,重建容器前先停服务、打包备份,再让新版本自动跑迁移(7 个 SQL 脚本,schema 0.30.1 → 0.31.8)。
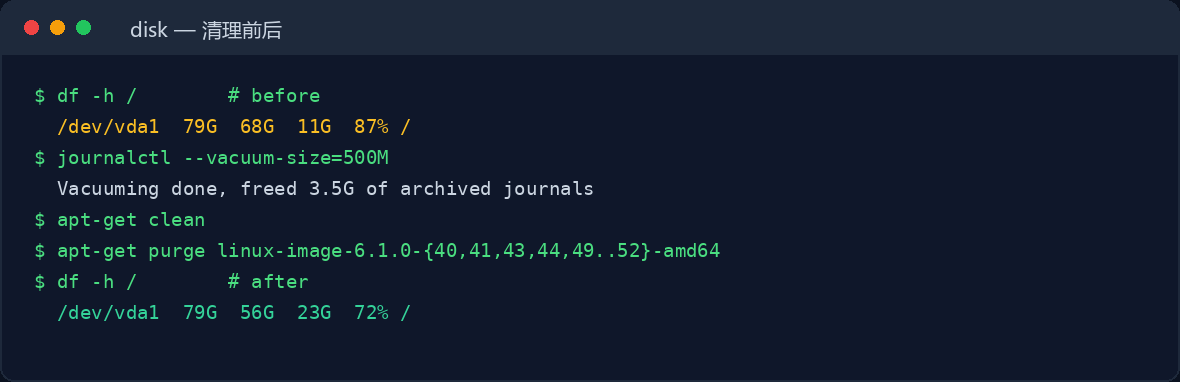
三、磁盘:从 87% 到 72%
回收分三块:journal 3.9G 压到 492M;apt 缓存 736M 清空;9 个旧内核只留“当前 + 上一个”,释放约 3.1G。再加上 Docker 构建缓存、过期面板备份和 9 月的站点旧备份,累计回收约 11G。
四、日志:2.8G 的单个文件
/www/wwwlogs 里,2114.hello0564.com.log 一个文件就 1.8G,从 1 月一直追加到 10 月,且没有任何 logrotate 规则。做法是新增一条轮转配置,然后强制轮转一次:
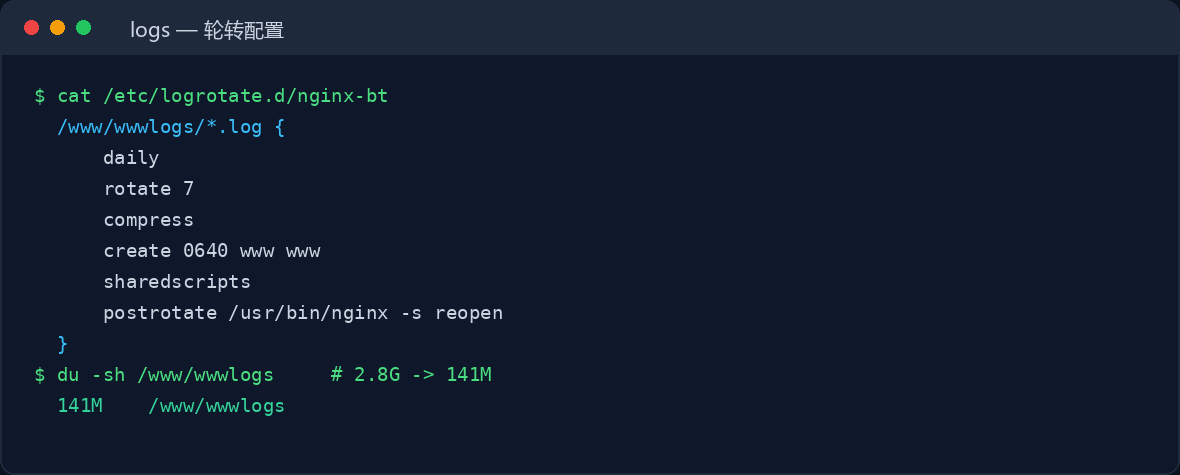
这里踩了一个坑:postrotate 里写成了 /usr/sbin/nginx,而宝塔的 nginx 实际在 /usr/bin/nginx。路径不存在又被 2>/dev/null 吞掉,导致 nginx 没重新打开日志文件,gzip 时报 file size changed while zipping。改用真实路径并加 sharedscripts 后正常。
五、三个故障:rc-local、MySQL、SSH
rc-local 每次启动都失败,原因是 /etc/rc.local 要挂载的 COS 目录不存在。补齐挂载点后,三个 cosfs 全部挂上,服务状态从 failed 变成 success。
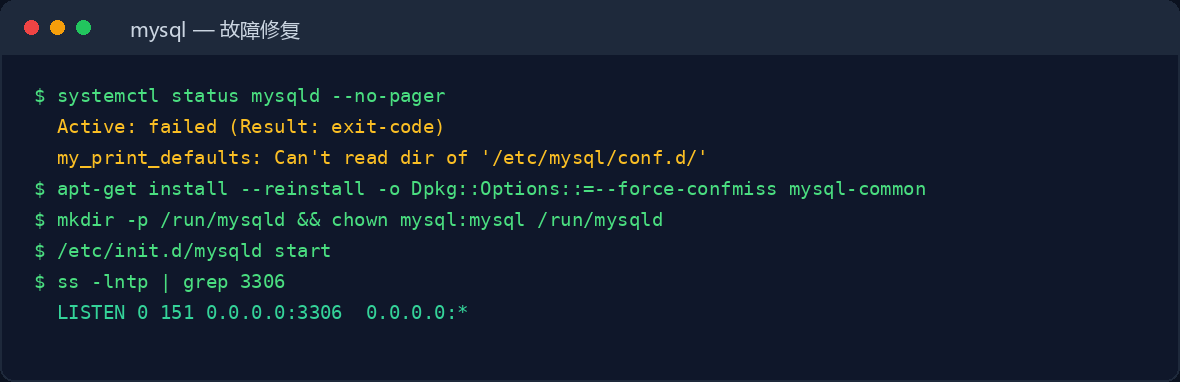
MySQL 是这次最意外的发现:mysqld 在升级窗口里正常 shutdown 后一直起不来,报 my_print_defaults: Can't read dir of '/etc/mysql/conf.d/'。根因是 /etc/mysql/conf.d 目录早先被删过,初始化脚本读不到 /etc/my.cnf 里的配置,回退到了不存在的 datadir。用 --force-confmiss 重装 mysql-common 后恢复正常,3306 重新监听。
SSH 则把 PermitRootLogin 从 yes 改成 prohibit-password,用 reload 而不是 restart,现有连接不断。
六、Docker 拉不动?先看加速源
升级 memos 时 docker pull 长时间卡住。看 journalctl -u docker 才发现:daemon.json 里 17 个公共加速源全部失效(403、401、TLS 握手超时),拉取一直在它们之间重试。
实测三个源后写入配置,顺序按“免认证且快”优先:
{
  "registry-mirrors": [
    "https://dockerproxy.net",
    "https://docker.1panel.live",
    "https://docker.m.daocloud.io"
  ]
}
最后用 alpine:3.20 做端到端验证,拉取成功、digest 正常,才算真正可用。
没有可用加速源时:给 Docker 临时挂代理
这台机器直连 registry-1.docker.io 是超时的。在确认三个新加速源可用之前,先用一个临时 HTTP 代理把镜像拉下来。注意:Docker 守护进程不读 shell 里的 export,必须写进 systemd drop-in。
mkdir -p /etc/systemd/system/docker.service.d
cat > /etc/systemd/system/docker.service.d/http-proxy.conf <<'EOF'
[Service]
Environment="HTTP_PROXY=http://114.103.11.85:1082"
Environment="HTTPS_PROXY=http://114.103.11.85:1082"
Environment="NO_PROXY=localhost,127.0.0.1,::1,10.0.0.0/8,172.16.0.0/12,192.168.0.0/16,.local,.internal"
EOF
systemctl daemon-reload
systemctl restart docker
写完后先验证代理是否真的能到 registry(返回 401 是正常的未认证响应):
curl -sS -x http://114.103.11.85:1082 -o /dev/null -w "%{http_code}\n" \
  https://registry-1.docker.io/v2/
# 401
这个代理同时开了 SOCKS5(7894),但 Docker 守护进程只认 HTTP_PROXY/HTTPS_PROXY,所以拉镜像统一用 HTTP 端口 1082。
镜像拉完、加速源也换好之后,立刻把临时代理撤掉,避免代理哪天失效反过来拖累 Docker:
rm -f /etc/systemd/system/docker.service.d/http-proxy.conf
rmdir /etc/systemd/system/docker.service.d
systemctl daemon-reload
systemctl restart docker两个注意点:重启 Docker 会让所有容器短暂中断(这台机器约 10 秒,有 restart 策略的会自动拉起);NO_PROXY 必须包含回环和内网段,否则容器之间互相访问也会被塞进代理,出现莫名其妙的连接失败。
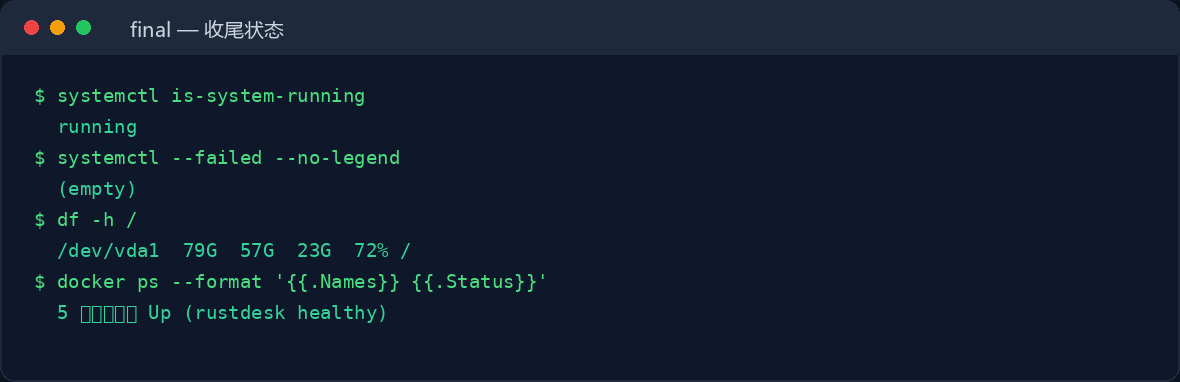
七、收尾状态
经验清单
- 镜像标签不等于版本。
hbbs --version/memos version才是真的。 - 升级前先看数据在哪。 bind mount 的服务可以放心重建;数据在容器内层的必须先搬出来。
- Syncthing 缺
.stfolder时不要直接补标记。 它会先把本地“空目录”当成删除,再同步给对端。 postrotate要写真实二进制路径,并且别用2>/dev/null把错误吞掉。- 加速源失效的表现是“卡住”而不是报错,先看 dockerd 日志。
- memos 的镜像 tag 没有 v 前缀,是
0.31.0,不是v0.31.0。
维护结束后:内核 6.1.0-54,待更新 0,磁盘 72%,五个容器全部健康,自动安全更新已启用。还剩两件事没动:宝塔 10000 端口的收紧方案,以及那台跑了 4 年的 wiz 镜像留着没有迁移。
Debian 12 生产服务器加固实录:从 SSH 爆破到 Docker 镜像治理的完整闭环:https://www.hao0564.com/6503.html